
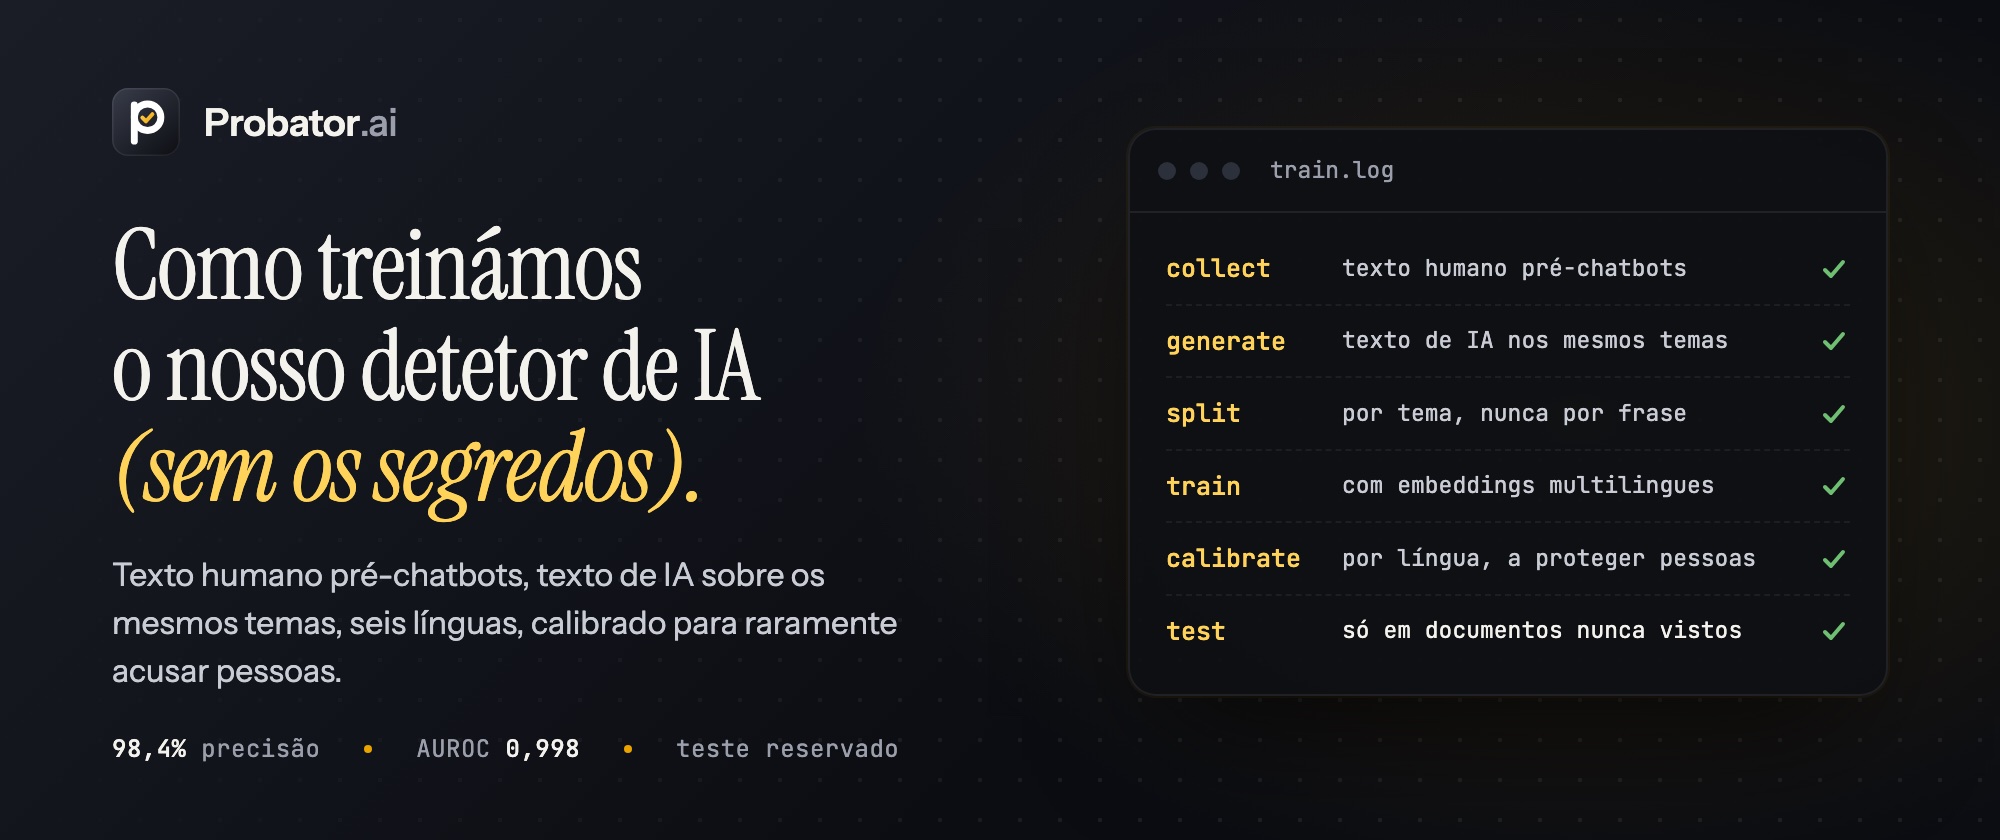
Como treinámos um detetor multilingue de texto de IA (sem revelar os segredos)
Dados emparelhados, texto humano de antes dos chatbots, uma divisão que não deixa fugas e uma calibração que protege quem escreve: como foi treinado o modelo de deteção do Probator.
Construímos o nosso próprio modelo para detetar texto escrito por IA em seis línguas, e é ele que agora está por trás de cada verificação no Probator. Foi assim que o treinámos.
Vamos ser transparentes quanto ao método e guardar algumas coisas para nós:
- que modelos escreveram o nosso texto de IA de treino;
- quantos dados usámos;
- a arquitetura exata;
- os limiares.
Tudo o que torne um detetor mais fácil de enganar não tem lugar num artigo de blogue. Tudo o resto está aqui.
1. Ensinar «quem o escreveu», não «sobre o que é»
A forma mais fácil de construir um mau detetor de IA é recolher texto humano num sítio e texto de IA noutro. O modelo aprende que os artigos de enciclopédia são humanos e as respostas ao estilo de blogue são de IA, tem resultados excelentes no seu próprio conjunto de teste e falha em documentos reais.
Por isso, todos os dados de treino vêm em pares: um texto humano e um texto de IA escrito sobre o mesmo tema, na mesma língua e no mesmo género. A única diferença consistente que resta entre os dois lados é quem os escreveu, e é isso que o modelo tem de aprender.
2. Texto humano de antes dos chatbots
Não se pode ter a certeza de que um texto foi escrito por uma pessoa se foi publicado depois de 2022. Por isso, o lado humano vem de textos anteriores aos chatbots:
- artigos de enciclopédia;
- páginas web recolhidas há anos;
- artigos de imprensa;
- resumos académicos.
Cada texto passa por filtros de qualidade, e o material está distribuído por seis línguas: inglês, português, espanhol, francês, alemão e italiano.
A variedade de géneros importa tanto como o volume. A escrita formal, técnica e traduzida é aquela em que os detetores de IA mais vezes acusam pessoas, por isso esse tipo de texto está propositadamente bem representado.
3. Texto de IA de muitos modelos, escrito de muitas formas
O lado da IA é escrito por um conjunto variado de modelos atuais, com prompts que pedem géneros, extensões e tons diferentes. Um detetor treinado com um só modelo aprende os hábitos desse modelo. Um detetor treinado com muitos tem de aprender o que eles têm em comum.
Entram também dois tipos de texto de IA mais difíceis:
- texto humano melhorado por IA: um rascunho humano que um modelo reescreveu;
- texto «humanizado»: texto que um modelo escreveu com instruções para parecer humano.
4. Dividir por tema, nunca por frase
É neste passo que a maioria das avaliações caseiras erra. Nós pontuamos o texto passagem a passagem. Se baralhar as passagens ao acaso entre os conjuntos de treino e de teste, passagens do mesmo documento acabam nos dois lados. O modelo passa a reconhecer em parte documentos que já viu, e a precisão parece melhor do que é.
Em vez disso, dividimos por par temático. Cada par recebe um hash estável e vai, inteiro, para um de três conjuntos:
- treino: aquilo com que o modelo aprende;
- validação: aquilo com que calibramos;
- teste: aquilo que reportamos, e em que mais nada toca.
Um tema do conjunto de teste nunca foi visto no treino, nem pelo texto humano nem pelo texto de IA.
5. O modelo
Cada passagem é convertida num embedding multilingue de frase, a que se juntam algumas características de estilo simples. Uma pequena rede neuronal transforma isso numa probabilidade de a passagem ter sido escrita por máquina. As pontuações das passagens são combinadas numa pontuação para o documento inteiro.
A rede é propositadamente pequena. Acrescenta apenas milissegundos a uma verificação e é barata o suficiente para ser retreinada sempre que surgem novos modelos. As probabilidades são calibradas, por isso 0,8 significa aproximadamente 80% das vezes, e não apenas «mais do que 0,6».
6. Calibrar a pensar em quem pode ser acusado injustamente
Um detetor de IA comete dois tipos de erro, e não custam o mesmo. Deixar escapar um texto de IA é uma pena. Dizer a um professor que o ensaio que um aluno escreveu sozinho foi gerado por IA pode prejudicar alguém.
Por isso, o limiar de decisão é definido por língua, no conjunto de validação, para que no máximo 1 em cada 100 documentos humanos seja assinalado. Por cima do modelo aplicam-se mais três salvaguardas:
- Textos curtos: nenhum veredicto «gerado por IA» abaixo de 80 palavras, a não ser que haja provas inequívocas, como um resto de chatbot ou uma marca oculta.
- Concordância: o nosso modelo é um de vários sinais, a par de uma leitura especializada por um modelo de linguagem, de um teste de reescrita e de verificações forenses. O veredicto mais forte exige que dois deles concordem.
- Transparência: quando uma salvaguarda altera um resultado, o relatório indica-o.
7. Ir atrás dos próprios falsos positivos
Os benchmarks não encontram todas as fraquezas; os utilizadores encontram. No início, alguém nos enviou um documento que tinha escrito inteiramente sozinho, e o nosso modelo deu-lhe uma probabilidade de IA de 9%. Está abaixo de qualquer veredicto, mas um leitor atento não deveria ver 9% num texto inteiramente humano.
Analisámos que tipo de escrita era: formal, estruturada, com poucos toques pessoais. Acrescentámos mais escrita humana desse tipo aos dados de treino, voltámos a treinar e verificámos de novo. A lição mais geral: os textos com mais probabilidade de serem mal avaliados são os mais valiosos de recolher.
8. Treinar sem um cluster de GPU
Todo o pipeline corre em infraestrutura serverless: recolha de texto, geração de texto de IA, embeddings e treino. Não há nenhuma máquina sempre ligada. Isso moldou o desenho:
- Passos pequenos e retomáveis: cada passo é curto e guarda o seu estado, por isso o treino sobrevive a reinícios e timeouts. Os pesos do modelo são guardados em armazenamento de objetos depois de cada passo.
- Uma fila conduz a execução: cada passo concluído agenda o seguinte.
- Um watchdog: deteta um passo que ficou parado e volta a iniciá-lo.
- Execuções cumulativas: uma nova execução pode acrescentar textos novos a tudo o que foi recolhido antes, em vez de começar do zero.
A primeira versão parou a meio de uma época mais do que uma vez. Foi tornar cada passo retomável que tornou o treino aborrecido, que é como o treino deve ser.
9. Resultados
Em documentos de teste reservados, nas seis línguas:
- Precisão: 98,4%
- AUROC: 0,998
A AUROC mede até que ponto o modelo ordena o texto de IA acima do texto humano, seja qual for o limiar: 1,0 é perfeito, 0,5 é o mesmo que atirar uma moeda ao ar. Os resultados por língua estão na nossa página de precisão, que atualizamos sempre que um novo modelo entra em produção.
Ainda assim, um detetor nunca é uma prova. Os nossos resultados vêm acompanhados das razões que os sustentam, para que seja uma pessoa a tomar a decisão.
O que guardamos para nós, e porquê
Não publicamos:
- que modelos escreveram o texto de IA de treino;
- o volume dos dados;
- a forma exata da rede;
- os limiares.
Com eles, seria mais fácil ir ajustando um texto até passar despercebido ao detetor. Tudo o que lhe permite decidir se deve confiar nos resultados, o método, a forma como a divisão funciona e os resultados de teste, é público.