
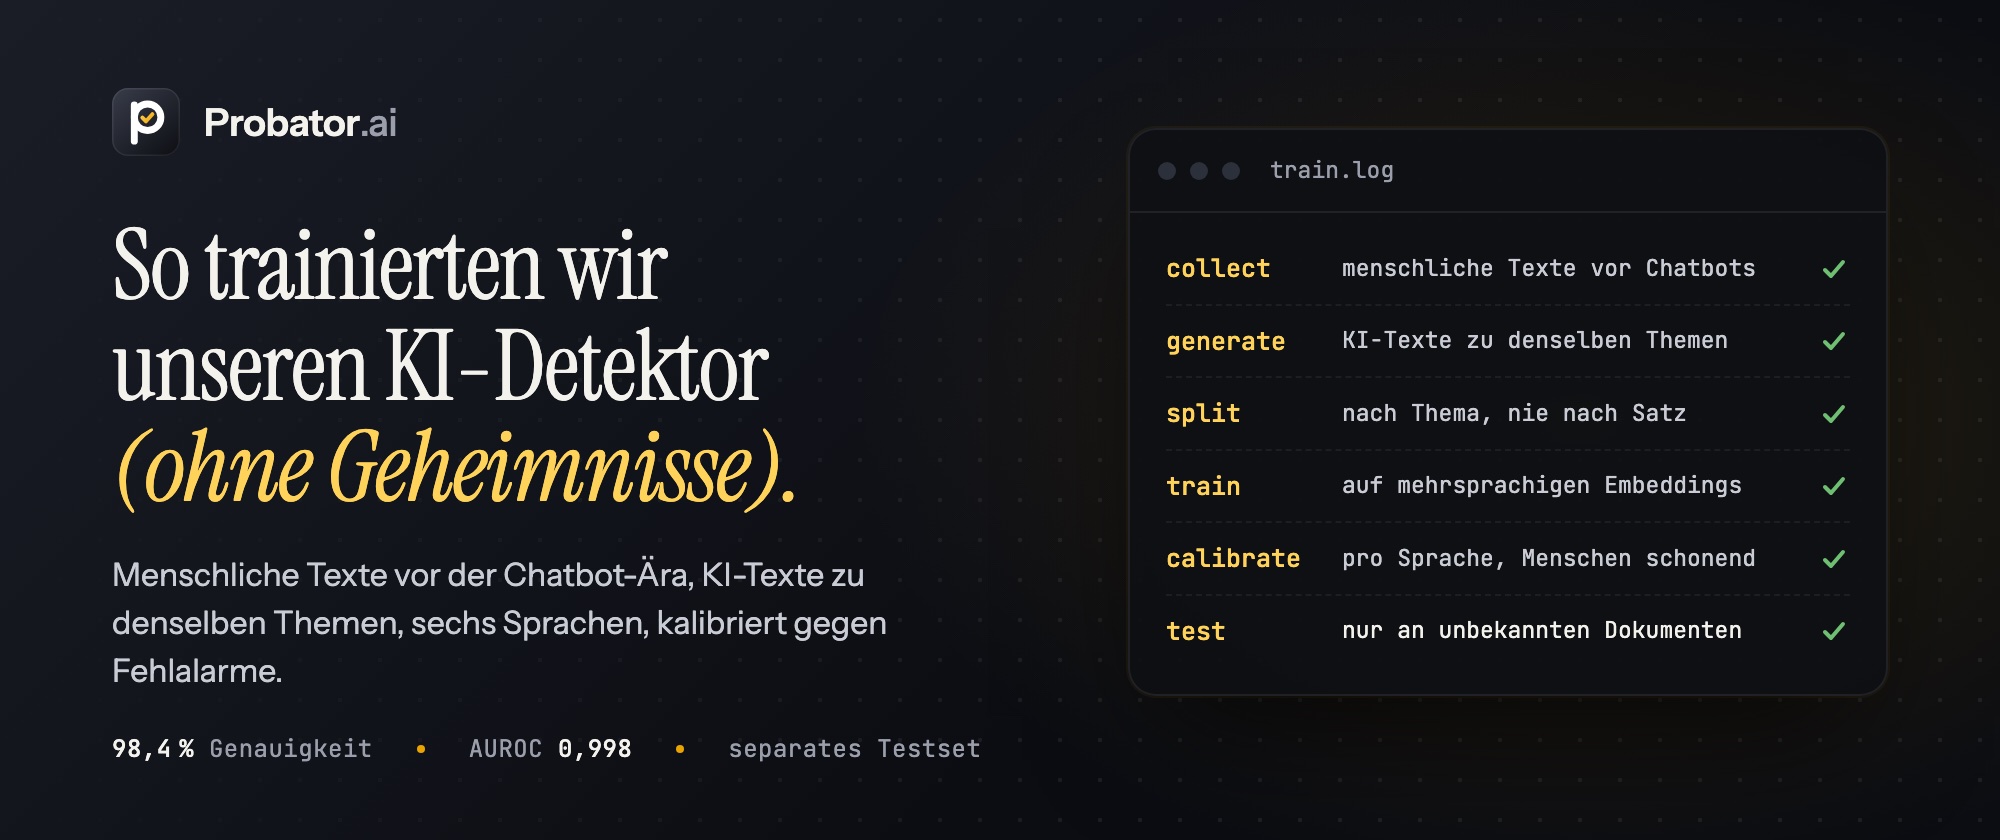
Wie wir einen mehrsprachigen KI-Textdetektor trainiert haben (ohne die Geheimnisse)
Gepaarte Daten, menschliche Texte aus der Zeit vor den Chatbots, eine Aufteilung ohne Datenlecks und eine Kalibrierung, die menschliche Autoren schützt: So wurde das Erkennungsmodell von Probator trainiert.
Wir haben ein eigenes Modell entwickelt, das KI-geschriebene Texte in sechs Sprachen erkennt, und es läuft inzwischen hinter jeder Prüfung auf Probator. So haben wir es trainiert.
Bei der Methode sind wir offen, ein paar Dinge behalten wir aber für uns:
- welche Modelle unsere KI-Trainingstexte geschrieben haben;
- wie viele Daten wir verwendet haben;
- die genaue Architektur;
- die Schwellenwerte.
Alles, was einen Detektor leichter austricksbar macht, gehört nicht in einen Blogbeitrag. Alles andere steht hier.
1. Lernen, „wer es geschrieben hat“, nicht „worum es geht“
Der einfachste Weg zu einem schlechten KI-Detektor: menschliche Texte aus einer Quelle sammeln und KI-Texte aus einer anderen. Das Modell lernt dann, dass Enzyklopädieartikel menschlich und Antworten im Blogstil KI sind, glänzt auf seinem eigenen Testset und scheitert an echten Dokumenten.
Deshalb kommen alle Trainingsdaten in Paaren: ein menschlicher Text und ein KI-Text zum selben Thema, in derselben Sprache und Textsorte. Der einzige durchgängige Unterschied zwischen beiden Seiten ist dann, wer sie geschrieben hat, und genau das muss das Modell lernen.
2. Menschliche Texte aus der Zeit vor den Chatbots
Bei einem Text, der nach 2022 veröffentlicht wurde, kann man nicht sicher sein, dass ein Mensch ihn geschrieben hat. Die menschliche Seite stammt deshalb aus Texten, die älter sind als die Chatbots:
- Enzyklopädieartikel;
- vor Jahren gecrawlte Webseiten;
- Nachrichtenartikel;
- wissenschaftliche Abstracts.
Jeder Text durchläuft Qualitätsfilter, und das Material verteilt sich auf sechs Sprachen: Englisch, Portugiesisch, Spanisch, Französisch, Deutsch und Italienisch.
Die Vielfalt der Textsorten zählt ebenso viel wie die Menge. Bei formellen, technischen und übersetzten Texten beschuldigen KI-Detektoren Menschen am häufigsten, deshalb sind solche Texte bewusst gut vertreten.
3. KI-Texte von vielen Modellen, auf viele Arten geschrieben
Die KI-Seite stammt von einer vielfältigen Auswahl aktueller Modelle, mit Prompts, die unterschiedliche Textsorten, Längen und Tonlagen verlangen. Ein Detektor, der auf ein einziges Modell trainiert wurde, lernt dessen Eigenheiten. Ein Detektor, der auf viele trainiert wurde, muss lernen, was sie gemeinsam haben.
Zwei schwierigere Arten von KI-Text kommen ebenfalls hinzu:
- Von KI überarbeitete menschliche Texte: ein menschlicher Entwurf, den ein Modell umgeschrieben hat;
- „Humanisierte“ Texte: Texte, die ein Modell mit der Anweisung geschrieben hat, menschlich zu klingen.
4. Nach Thema aufteilen, nie nach Satz
An diesem Schritt scheitern die meisten selbstgebauten Evaluierungen. Wir bewerten Text Passage für Passage. Verteilt man die Passagen zufällig auf Trainings- und Testset, landen Passagen desselben Dokuments auf beiden Seiten. Das Modell erkennt dann teilweise Dokumente wieder, die es schon gesehen hat, und die Genauigkeit wirkt besser, als sie ist.
Wir teilen stattdessen nach Themenpaar auf. Jedes Paar erhält einen stabilen Hash und landet vollständig in einem von drei Sets:
- Training: woraus das Modell lernt;
- Validierung: worauf wir kalibrieren;
- Test: was wir veröffentlichen, und sonst greift nichts darauf zu.
Ein Thema aus dem Testset kam im Training nie vor, weder im menschlichen noch im KI-Text.
5. Das Modell
Jede Passage wird zu einem mehrsprachigen Satz-Embedding, ergänzt um eine Handvoll einfacher Stilmerkmale. Ein kleines neuronales Netz berechnet daraus die Wahrscheinlichkeit, dass die Passage maschinell geschrieben ist. Die Werte der einzelnen Passagen werden zu einem Wert für das ganze Dokument zusammengeführt.
Das Netz ist bewusst klein. Es verlängert eine Prüfung nur um Millisekunden und ist günstig genug, um es jedes Mal neu zu trainieren, wenn neue Modelle erscheinen. Die Wahrscheinlichkeiten sind kalibriert: 0,8 bedeutet also in etwa 80 % der Fälle und nicht bloß „höher als 0,6“.
6. Kalibrieren für die Person, die zu Unrecht beschuldigt werden könnte
Ein KI-Detektor macht zwei Arten von Fehlern, und sie wiegen nicht gleich schwer. Einen KI-Text zu übersehen ist schade. Einer Lehrkraft zu sagen, der selbst geschriebene Aufsatz eines Schülers sei KI-generiert, kann einem Menschen schaden.
Deshalb wird die Entscheidungsschwelle pro Sprache auf dem Validierungsset so festgelegt, dass höchstens 1 von 100 menschlichen Dokumenten markiert wird. Zusätzlich zum Modell greifen drei weitere Schutzregeln:
- Kurze Texte: unter 80 Wörtern kein Urteil „KI-generiert“, es sei denn, es gibt harte Belege wie ein Chatbot-Überbleibsel oder eine versteckte Markierung.
- Übereinstimmung: Unser Modell ist eines von mehreren Signalen, neben einer Expertenanalyse durch ein Sprachmodell, einem Umschreibtest und forensischen Prüfungen. Für das stärkste Urteil müssen zwei davon übereinstimmen.
- Transparenz: Ändert eine Schutzregel ein Ergebnis, steht das im Bericht.
7. Den eigenen Fehlalarmen nachgehen
Benchmarks finden nicht jede Schwachstelle, die Nutzer schon. Früh schickte uns jemand ein Dokument, das er vollständig selbst geschrieben hatte, und unser Modell gab ihm eine KI-Wahrscheinlichkeit von 9 %. Das liegt unter jeder Urteilsschwelle, aber wer genau hinsieht, sollte bei komplett menschlichem Text keine 9 % sehen.
Wir haben uns angesehen, um welche Art von Text es sich handelte: formell, strukturiert, mit wenig persönlicher Note. Wir haben mehr menschliche Texte dieser Art in die Trainingsdaten aufgenommen, neu trainiert und erneut geprüft. Die allgemeinere Lehre: Die Texte, die am ehesten falsch beurteilt werden, sind die wertvollsten zum Sammeln.
8. Training ohne GPU-Cluster
Die gesamte Pipeline läuft auf Serverless-Infrastruktur: Texte sammeln, KI-Texte generieren, Embeddings berechnen und trainieren. Es gibt keine dauerhaft laufende Maschine. Das hat das Design geprägt:
- Kleine, fortsetzbare Schritte: Jeder Schritt ist kurz und speichert seinen Zustand, sodass das Training Neustarts und Timeouts übersteht. Die Gewichte des Modells werden nach jedem Schritt als Checkpoint im Object Storage gesichert.
- Eine Warteschlange steuert den Lauf: Jeder abgeschlossene Schritt plant den nächsten ein.
- Ein Watchdog: Er bemerkt einen hängengebliebenen Schritt und startet ihn neu.
- Additive Läufe: Ein neuer Lauf kann frische Texte zu allem bisher Gesammelten hinzufügen, statt bei null anzufangen.
Die erste Version blieb mehr als einmal mitten in einer Epoche hängen. Erst als jeder Schritt fortsetzbar war, wurde das Training langweilig, und genau so sollte Training sein.
9. Ergebnisse
Auf zurückgehaltenen Testdokumenten, in allen sechs Sprachen:
- Genauigkeit: 98,4 %
- AUROC: 0,998
Die AUROC misst, wie zuverlässig das Modell KI-Text höher einstuft als menschlichen Text, unabhängig vom Schwellenwert: 1,0 ist perfekt, 0,5 entspricht einem Münzwurf. Die Ergebnisse nach Sprache stehen auf unserer Genauigkeitsseite, und wir aktualisieren sie, sobald ein neues Modell live geht.
Ein Detektor ist allerdings nie ein Beweis. Unsere Ergebnisse kommen mit den Gründen dahinter, damit ein Mensch die Entscheidung treffen kann.
Was wir für uns behalten, und warum
Wir veröffentlichen nicht:
- welche Modelle die KI-Trainingstexte geschrieben haben;
- den Umfang der Daten;
- die genaue Form des Netzes;
- die Schwellenwerte.
Mit diesen Angaben ließe sich ein Text leichter so lange anpassen, bis er unter dem Detektor hindurchrutscht. Alles, woran Sie erkennen, ob Sie den Ergebnissen trauen können, ist öffentlich: die Methode, die Funktionsweise der Aufteilung und die Testergebnisse.