
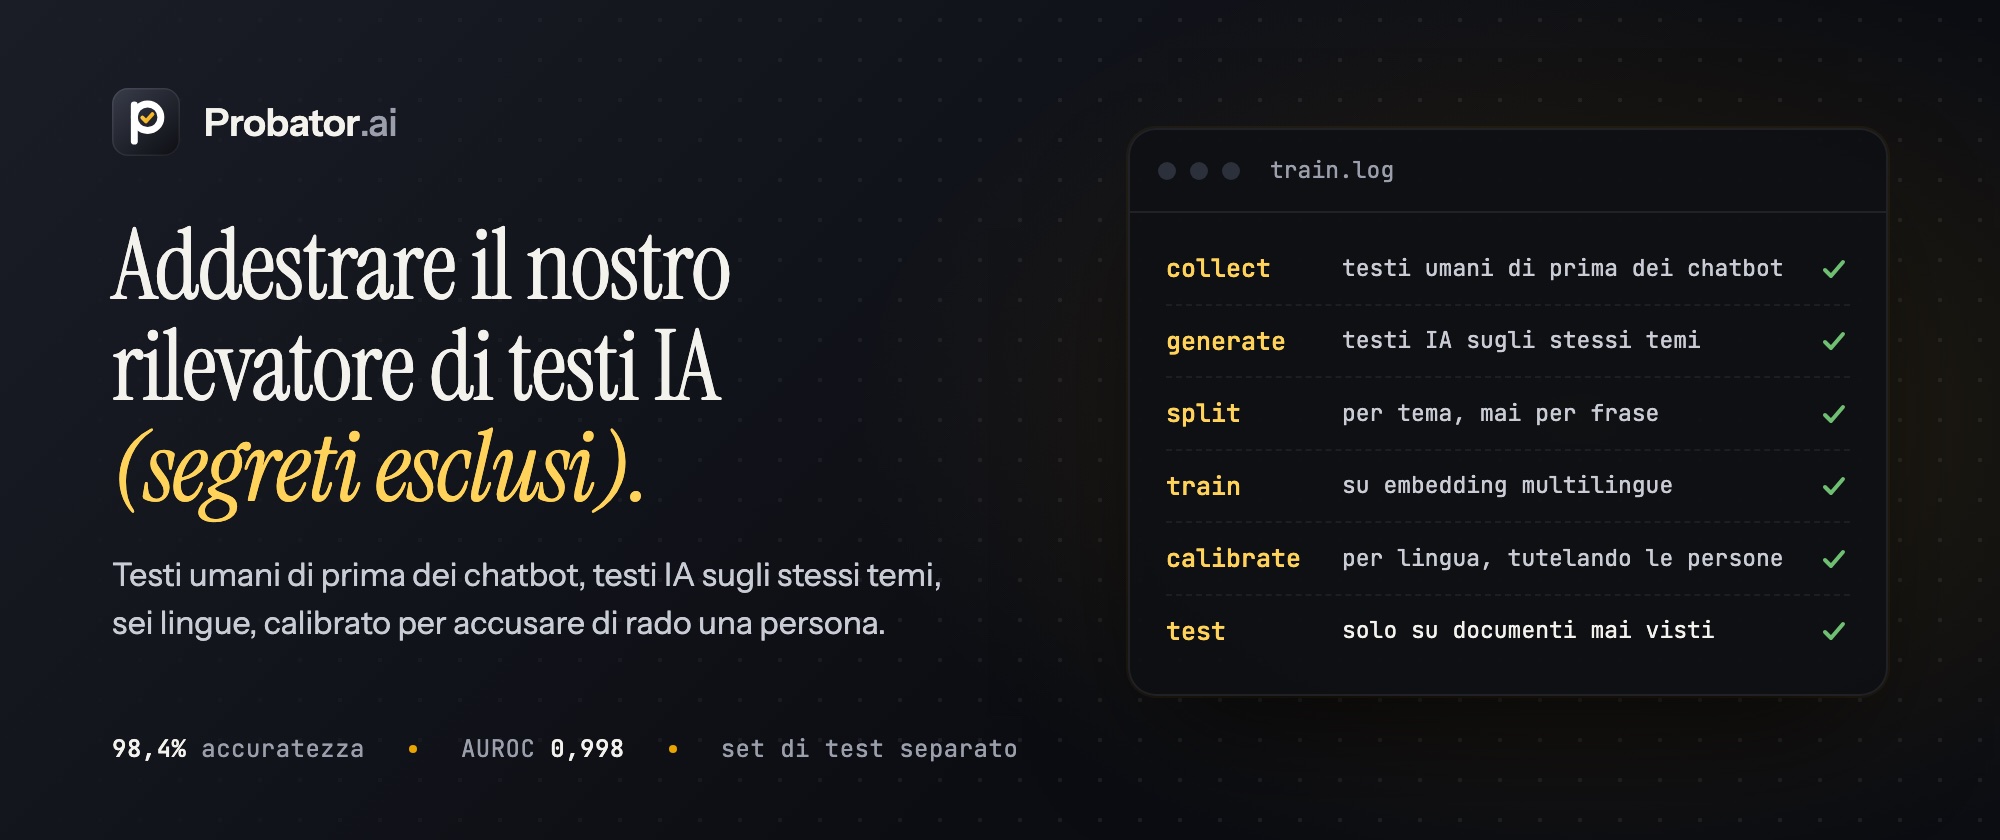
Come abbiamo addestrato un rilevatore di testi IA multilingue (segreti esclusi)
Dati in coppia, testi umani di prima dei chatbot, una suddivisione senza fughe di dati e una calibrazione che protegge chi scrive: come è stato addestrato il modello di rilevamento di Probator.
Abbiamo costruito un nostro modello per rilevare i testi scritti dall'IA in sei lingue, e oggi lavora dietro ogni verifica su Probator. Ecco come l'abbiamo addestrato.
Saremo trasparenti sul metodo, ma alcune cose le teniamo per noi:
- quali modelli hanno scritto i nostri testi IA di addestramento;
- quanti dati abbiamo usato;
- l'architettura esatta;
- le soglie.
Tutto ciò che rende un rilevatore più facile da ingannare non ha posto in un articolo di blog. Tutto il resto è qui.
1. Insegnare “chi l'ha scritto”, non “di cosa parla”
Il modo più facile per costruire un cattivo rilevatore di IA è raccogliere i testi umani da una fonte e i testi IA da un'altra. Il modello impara che le voci enciclopediche sono umane e le risposte in stile blog sono IA, ottiene punteggi splendidi sul proprio set di test e poi fallisce sui documenti reali.
Per questo ogni dato di addestramento arriva in coppie: un testo umano e un testo IA scritto sullo stesso argomento, nella stessa lingua e nello stesso genere. L'unica differenza costante che resta tra i due lati è chi li ha scritti, ed è proprio questo che il modello deve imparare.
2. Testi umani di prima dei chatbot
Non puoi essere sicuro che un testo sia stato scritto da una persona se è stato pubblicato dopo il 2022. Per questo il lato umano proviene da testi precedenti ai chatbot:
- voci enciclopediche;
- pagine web raccolte anni fa;
- articoli di giornale;
- abstract accademici.
Ogni testo passa attraverso filtri di qualità, e il materiale è distribuito su sei lingue: inglese, portoghese, spagnolo, francese, tedesco e italiano.
La varietà dei generi conta quanto il volume. La scrittura formale, tecnica e tradotta è quella in cui i rilevatori di IA accusano più spesso le persone, quindi questo tipo di testo è volutamente ben rappresentato.
3. Testi IA da molti modelli, scritti in molti modi
Il lato IA è scritto da un insieme variegato di modelli attuali, con prompt che chiedono generi, lunghezze e toni diversi. Un rilevatore addestrato su un solo modello impara le abitudini di quel modello. Uno addestrato su molti deve imparare ciò che hanno in comune.
Entrano anche due tipi di testo IA più difficili:
- Testo umano rifinito dall'IA: una bozza umana riscritta da un modello;
- Testo “umanizzato”: testo scritto da un modello con l'istruzione di sembrare umano.
4. Dividere per argomento, mai per frase
È il passaggio che la maggior parte delle valutazioni fatte in casa sbaglia. Noi valutiamo il testo passaggio per passaggio. Se distribuisci i passaggi a caso tra set di addestramento e set di test, passaggi dello stesso documento finiscono su entrambi i lati. Il modello allora riconosce in parte documenti che ha già visto, e la tua accuratezza sembra migliore di quanto sia.
Noi invece dividiamo per coppia tematica. Ogni coppia riceve un hash stabile e finisce, per intero, in uno di tre set:
- addestramento: ciò da cui il modello impara;
- validazione: ciò su cui calibriamo;
- test: ciò su cui riportiamo i risultati, e nient'altro lo tocca.
Un argomento del set di test non è mai stato visto durante l'addestramento, né nel testo umano né in quello IA.
5. Il modello
Ogni passaggio diventa un embedding multilingue delle frasi, a cui si aggiungono alcune semplici caratteristiche stilistiche. Una piccola rete neurale trasforma tutto questo nella probabilità che il passaggio sia stato scritto da una macchina. I punteggi dei passaggi vengono poi combinati in un punteggio per l'intero documento.
La rete è volutamente piccola. Aggiunge solo pochi millisecondi a una verifica, ed è abbastanza economica da poterla riaddestrare ogni volta che escono nuovi modelli. Le probabilità sono calibrate, quindi 0,8 significa più o meno l'80% delle volte, non semplicemente “più di 0,6”.
6. Calibrare pensando a chi potrebbe essere accusato ingiustamente
Un rilevatore di IA può commettere due tipi di errore, e non costano lo stesso. Lasciarsi sfuggire un testo IA è un peccato. Dire a un docente che il tema scritto da uno studente è generato dall'IA può fare del male a qualcuno.
Per questo la soglia di decisione è fissata per lingua, sul set di validazione, in modo che al massimo 1 documento umano su 100 venga segnalato. Oltre al modello si applicano altre tre salvaguardie:
- Testi brevi: nessun verdetto “generato dall'IA” sotto le 80 parole, a meno che non ci siano prove concrete come un residuo di chatbot o un segno nascosto.
- Accordo: il nostro modello è uno dei vari segnali, insieme a una lettura da esperto affidata a un modello linguistico, un test di riscrittura e verifiche forensi. Il verdetto più forte richiede che due di essi siano d'accordo.
- Trasparenza: quando una salvaguardia modifica un risultato, il report lo dice.
7. Andare a caccia dei propri falsi positivi
I benchmark non trovano ogni punto debole; gli utenti sì. All'inizio qualcuno ci ha inviato un documento scritto interamente di suo pugno, e il nostro modello gli ha attribuito una probabilità di IA del 9%. È al di sotto di qualsiasi verdetto, ma un lettore attento non dovrebbe vedere un 9% su un testo interamente umano.
Abbiamo guardato che tipo di scrittura fosse: formale, strutturata, con pochi tocchi personali. Abbiamo aggiunto ai dati di addestramento altri testi umani di quel tipo, abbiamo riaddestrato il modello e verificato di nuovo. La lezione più generale: i testi che rischiano di più di essere giudicati male sono i più preziosi da raccogliere.
8. Addestrare senza un cluster di GPU
L'intera pipeline gira su un'infrastruttura serverless: raccolta dei testi, generazione dei testi IA, embedding e addestramento. Non c'è nessuna macchina sempre accesa. Questo ha condizionato il design:
- Piccoli passi riprendibili: ogni passo è breve e salva il proprio stato, così l'addestramento sopravvive a riavvii e timeout. Dopo ogni passo, i pesi del modello vengono salvati in un object storage.
- Una coda guida l'esecuzione: ogni passo completato pianifica il successivo.
- Un watchdog: si accorge quando un passo si è bloccato e lo riavvia.
- Esecuzioni incrementali: una nuova esecuzione può aggiungere testi nuovi a tutto ciò che è stato raccolto prima, invece di ripartire da zero.
La prima versione si è bloccata a metà di un'epoca più di una volta. Rendere ogni passo riprendibile è ciò che ha reso l'addestramento noioso, ed è esattamente così che dovrebbe essere.
9. Risultati
Sui documenti di test tenuti da parte, in tutte e sei le lingue:
- Accuratezza: 98,4%
- AUROC: 0,998
L'AUROC misura quanto bene il modello colloca i testi IA sopra quelli umani, a prescindere dalla soglia: 1,0 è perfetto, 0,5 equivale a lanciare una moneta. I risultati per lingua sono nella nostra pagina sull'accuratezza, che aggiorniamo ogni volta che entra in funzione un nuovo modello.
Un rilevatore, però, non è mai una prova. I nostri risultati sono accompagnati dalle loro motivazioni, così la decisione spetta a una persona.
Cosa teniamo per noi, e perché
Non pubblichiamo:
- quali modelli hanno scritto i testi IA di addestramento;
- la quantità di dati;
- la forma esatta della rete;
- le soglie.
Con queste informazioni sarebbe più facile ritoccare un testo finché non sfugge al rilevatore. Tutto ciò che ti serve per decidere se fidarti dei risultati, cioè il metodo, il funzionamento della suddivisione e i risultati dei test, è pubblico.